Un historique de sessions inexploitable en pratique
Claude Code journalise chaque session de travail dans des fichiers JSONL faits pour la machine. L'historique existe donc, mais il est inexploitable en pratique : on ne peut ni y relire le raisonnement qui a mené à un choix, ni y retrouver une commande passée, ni annoter une décision de conception. L'outil supprime en plus par défaut toute session restée inactive trente jours, si bien que ce raisonnement finit par disparaître.
Comme j'utilise aujourd'hui beaucoup Claude Code, j'avais besoin de mettre en forme ses sorties et de garder une trace des sessions où un compromis avait été pesé, un benchmark tranché ou une impasse déjà explorée. Le commit dit ce qui a changé, et je voulais un outil capable de montrer pourquoi.
Un seul fichier Python sans dépendance
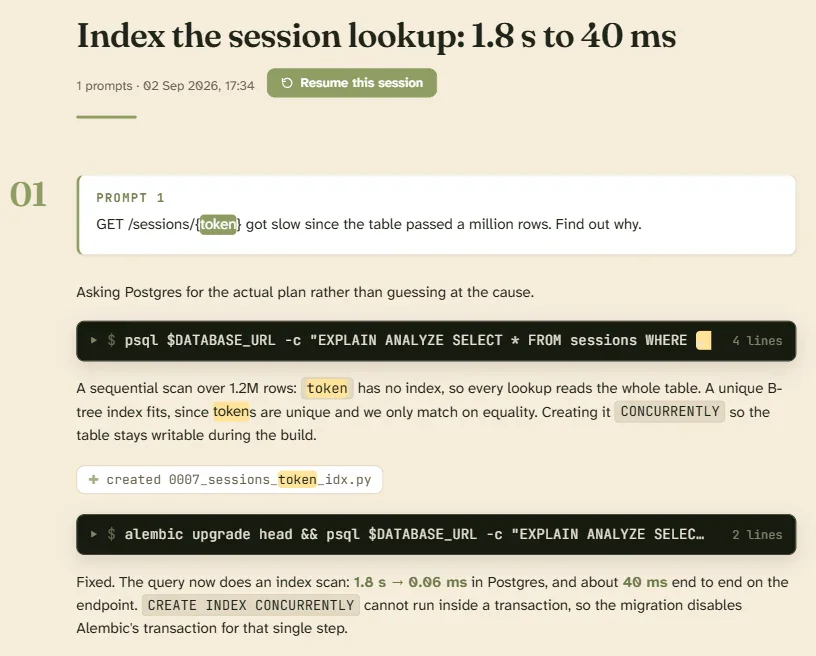
Memorium tient dans un seul fichier Python de 2 479 lignes, sans aucune dépendance en dehors de la standard library, qui regroupe la ligne de commande, le générateur HTML, l'index de recherche et le viewer. La commande principale lit les logs de Claude Code, génère un site statique et l'ouvre dans le navigateur. Chaque session y devient un transcript mis en page pour une lecture longue, avec les prompts, les réponses, les appels d'outils et la sortie du terminal, et un dashboard présente l'activité de la semaine et les dernières sessions de chaque projet.
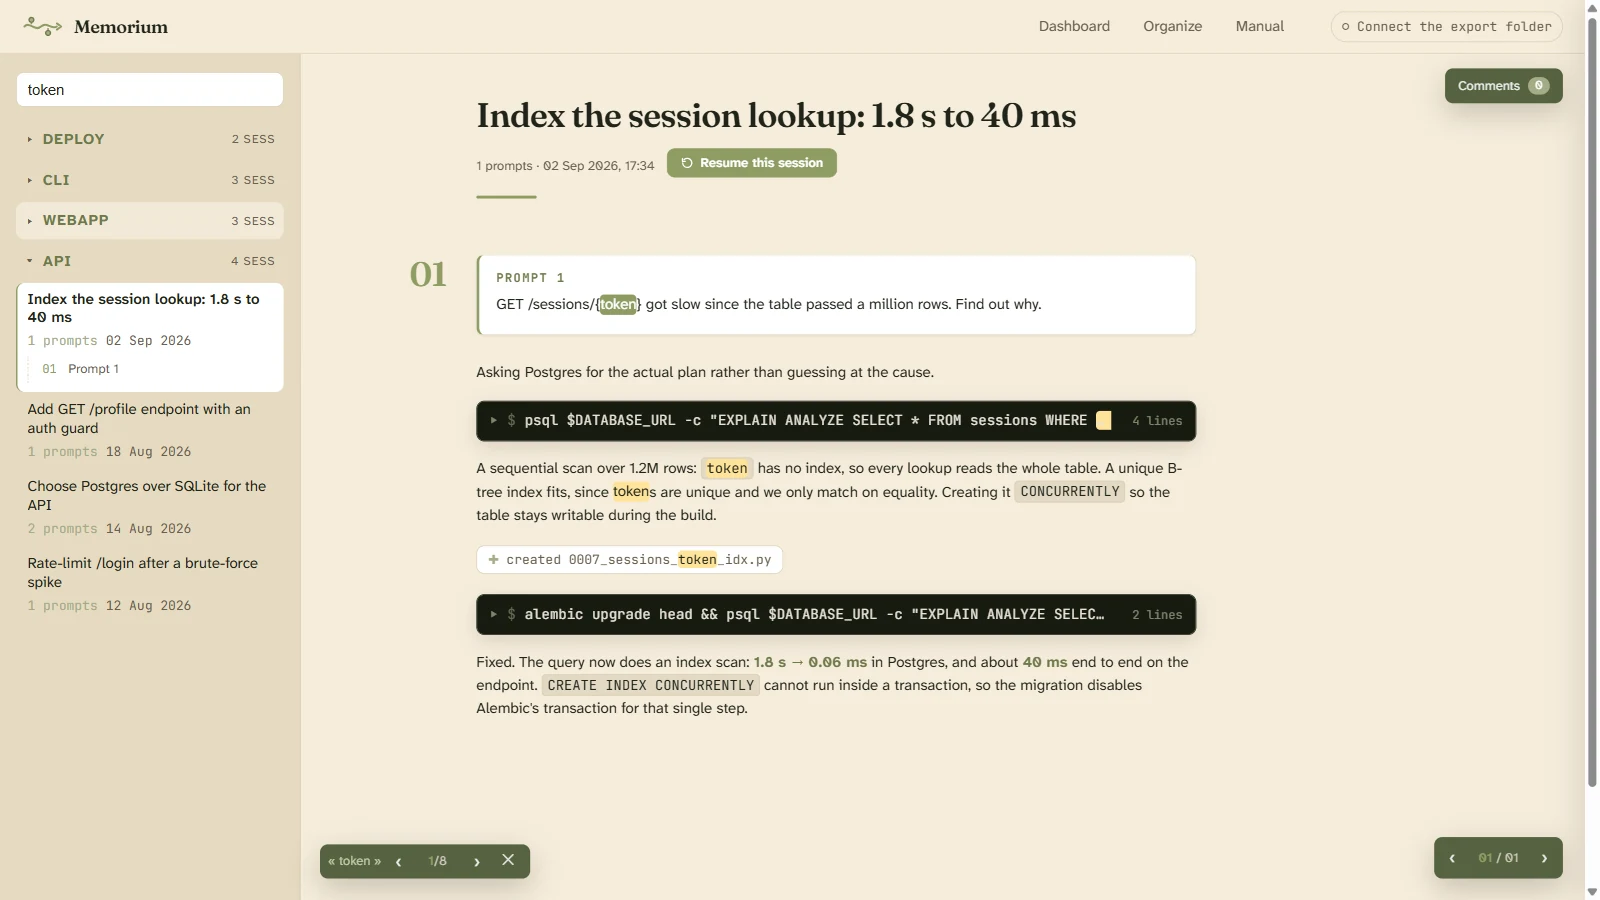
La recherche plein texte repose sur un index construit une seule fois à l'export et embarqué dans le site, ce qui la rend instantanée sans serveur. Les polices sont intégrées à la page et rien n'est chargé depuis le réseau, de sorte que le journal s'ouvre n'importe où, même sans connexion.
Un second volet protège l'historique lui-même. Une commande d'initialisation relève le délai de purge de Claude Code après avoir sauvegardé sa configuration, puis installe un hook qui archive chaque session dès qu'elle se termine. Les logs bruts sont compressés de manière incrémentale, et une commande de restauration remet une session à sa place pour qu'on puisse la reprendre, y compris sur une autre machine ou après sa purge.
Une source jamais modifiée et quatre ADR
J'ai fait de l'absence de dépendance une contrainte de conception, puisqu'un seul fichier en standard library s'audite d'une traite, reste installable partout et ne risque pas de casser au gré des mises à jour d'une bibliothèque tierce. Cette contrainte a orienté tout le reste du projet, à commencer par l'absence de backend.
Le dossier des logs appartient à Claude Code, qui l'indexe pour pouvoir reprendre une session. Renommer un dossier ou déplacer un fichier à cet endroit aurait cassé la reprise, et j'ai donc posé comme règle de ne jamais modifier la source. Les renommages, les déplacements et les annotations vivent dans une couche de metadata dérivée, résolue au moment de l'affichage et entièrement réversible, sur le principe d'une vue de base de données appliqué à des fichiers plats.
Écrire ces metadata depuis le navigateur demandait la File System Access API, désactivée sur une page ouverte en local. Une sous-commande sert donc le site sur localhost, qui constitue un secure context, avec un simple serveur statique sans aucune logique métier. Le site reste ainsi lisible tel quel, et le serveur n'intervient que pour l'écriture.
J'ai consigné ces décisions dans quatre ADR, chacun accompagné de la condition qui justifierait de le revoir. Leur rédaction a eu un effet que je n'attendais pas : en relisant le code pour expliquer chaque choix, j'ai trouvé deux vrais bugs, que j'ai corrigés et documentés.
Publié sur PyPI après une revue complète du dépôt
Avant de rendre l'outil public, j'ai passé le dépôt en revue de bout en bout, ce qui a fait remonter un bug de la ligne de commande dans lequel l'option d'aide créait un dossier portant son nom. Un numéro de version publié sur PyPI ne peut jamais être réutilisé, et j'ai donc corrigé le bug avant de tagger la version, puis validé le paquet sur TestPyPI et vérifié son installation depuis l'index distant dans un environnement vierge.
La version 1.0.0 est publiée sous le nom memorium-cli, avec un tag annoté, une release qui contient la wheel et la source, un changelog et un README illustré d'une vidéo de démonstration. Le token de publication n'a jamais été stocké dans le dépôt et a été restreint au seul projet après le premier envoi.
Installable avec pipx et des tests comme prochaine étape
Une seule commande pipx install memorium-cli suffit à n'importe qui pour installer l'outil. Sur mon propre historique de plusieurs mois, Memorium exporte 68 sessions en deux secondes, l'ensemble de l'application tient en 243 Ko polices comprises, et l'archive compresse 197 Mo de logs bruts en 62 Mo. La CI exécute à chaque push le lint Ruff, une compilation et un smoke test sur Python 3.8 à 3.13.
La couverture de tests reste aujourd'hui la limite du projet, et c'est pour cette raison que le lint se cantonne volontairement à des règles qui ne changent pas le comportement du code. Étoffer ces tests est la prochaine étape avant d'élargir le lint.