Un problème de tournées de livraison enrichi de deux contraintes réelles
Le projet s'inscrit dans un scénario où notre structure, CesiCDP, répond à un appel à manifestation d'intérêt de l'ADEME sur les nouvelles solutions de mobilité. La mission consistait à proposer une solution algorithmique capable de limiter les déplacements et la consommation des véhicules lors des cycles de livraison, en calculant sur un réseau routier des tournées qui relient un ensemble de villes avant de revenir au point de départ, au coût total le plus faible possible.
Le sujet de base correspondait au problème du voyageur de commerce, et nous avons choisi de l'enrichir de deux contraintes pour nous rapprocher d'une situation réelle. Une entreprise de livraison dispose rarement d'un seul véhicule, ce qui nous a fait passer d'un TSP à un VRP, où plusieurs véhicules partent du même dépôt et se répartissent les clients. Toutes les routes d'un réseau ne sont pas non plus disponibles en permanence, et nous avons donc intégré des routes fermées pour travaux ainsi que des routes à surcoût, comme celles à péage.
Une chaîne en quatre étapes du générateur aux métaheuristiques
Le projet suit une chaîne en quatre étapes. Un générateur produit d'abord des réseaux routiers aléatoires, en graphe complet ou en reliant chaque ville à ses plus proches voisines, avec une part de routes fermées et de routes à surcoût. Un constructeur glouton fournit ensuite une première solution valide : chaque véhicule ajoute à tour de rôle le client accessible le moins coûteux, et repasse par le dépôt lorsqu'il se retrouve bloqué par des routes fermées. Ce glouton est rendu aléatoire par une liste restreinte de candidats, selon le principe GRASP, de sorte que chaque lancement parte d'un point différent.
Trois métaheuristiques améliorent ensuite cette solution de départ. La recherche tabou explore les solutions voisines en échangeant deux villes d'une même tournée ou en déplaçant une ville d'une tournée à une autre, et garde en mémoire les dernières solutions visitées pour ne pas tourner en rond. Le recuit simulé accepte des solutions moins bonnes avec une probabilité qui décroît au fil des itérations, et l'algorithme génétique fait évoluer une population de solutions. Une dernière étape calibre les paramètres de chaque méthode puis les compare sur des instances de taille croissante.
Le modèle mathématique puis le calibrage des paramètres
Nous avons consacré une part importante du projet à modéliser clairement le problème avant d'écrire la moindre ligne de code. Le modèle pose une variable de décision par route et par véhicule, une fonction objectif qui somme le coût des routes empruntées, et cinq contraintes qui imposent la visite unique de chaque client, la conservation du flot, le départ et le retour au dépôt et l'interdiction des routes fermées. Nous avons ensuite montré que notre problème se ramène au voyageur de commerce lorsqu'on fixe le nombre de véhicules à un et qu'on retire les routes interdites. Cette réduction établit que le problème est NP-difficile, ce qui légitime le recours aux métaheuristiques plutôt qu'à une résolution exacte, et elle nous a permis de nous appuyer sur une littérature déjà abondante pour choisir et calibrer nos méthodes.
Les routes fermées pouvaient être traitées de deux manières. La première consiste à leur attribuer un coût très élevé pour qu'aucun algorithme ne les choisisse, ce qu'on appelle la méthode du Big-M, et la seconde à les retirer directement du graphe avant la résolution. Nous avons retenu la seconde, qui réduit le nombre de variables et évite les instabilités numériques, tout en gardant dans la fonction de coût un garde-fou qui écarte toute solution empruntant malgré tout une route fermée.
Pour compenser le caractère local de la recherche tabou, nous l'avons relancée plusieurs fois depuis des solutions initiales différentes produites par le GRASP, en ne conservant que la meilleure. Cette stratégie multi-start s'est révélée la plus efficace de l'étude.
Le calibrage des paramètres suit la méthode OFAT, qui fait varier un seul paramètre à la fois en gardant les autres à leur valeur de référence. Chaque configuration a été évaluée sur dix instances générées aléatoirement, en mesurant le coût moyen et son écart-type afin que les conclusions ne dépendent pas d'un graphe particulier.
Tabou et recuit gagnent 20 à 32 % sur le glouton
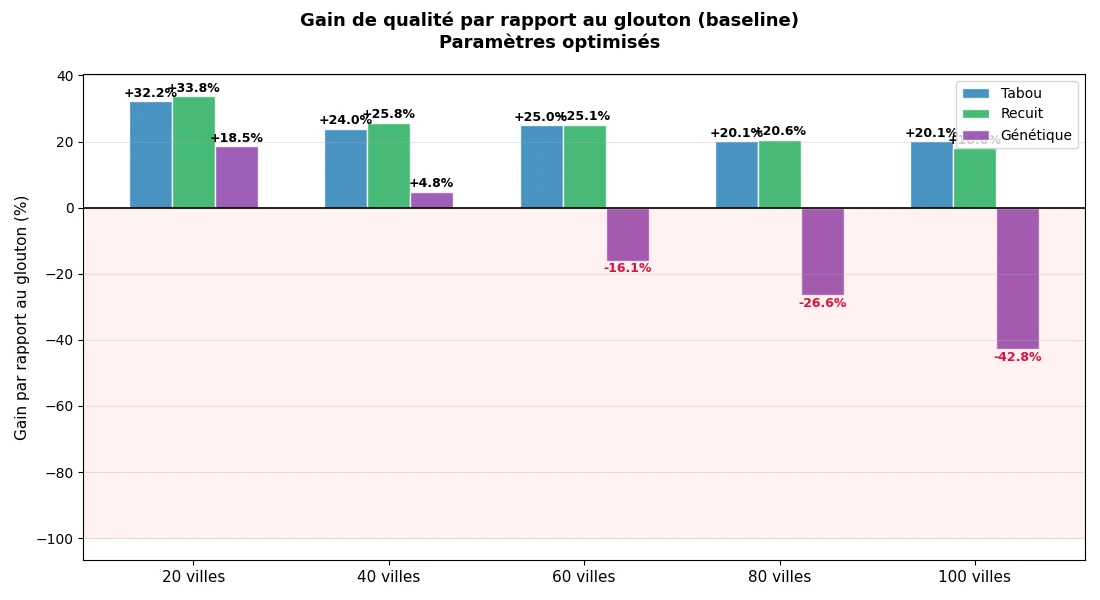
Sur l'étude complète, de vingt à cent villes avec les paramètres calibrés, la recherche tabou et le recuit simulé sont les approches les plus robustes, avec un gain de 20 à 32 % sur le glouton qui se stabilise autour de 20 % sur les plus grandes instances. Le recuit atteint la même qualité que la recherche tabou mais se montre bien plus lent, avec 108 secondes contre 0,8 dans la comparaison rapide à trente villes, ce qui fait de la recherche tabou multi-start le meilleur compromis entre qualité et temps de calcul.
L'algorithme génétique est compétitif sur les petites instances, avec un gain de 18,5 % à vingt villes, puis se dégrade à mesure que la taille augmente et finit en dessous du glouton à cent villes. À taille de population et nombre de générations fixés, son budget de calcul ne suit pas la croissance du problème.
Un notebook noté A puis un module Python public
Le livrable prend la forme d'un notebook qui va de la modélisation formelle à l'analyse statistique, appuyé sur une bibliographie d'une quinzaine de références, et le projet a obtenu la note A au livrable comme à la soutenance. J'ai ensuite extrait le code du notebook en un module Python réutilisable, publié dans un dépôt public avec un test de fumée en intégration continue, une version taguée et un README bilingue afin que l'étude puisse être relancée et vérifiée par n'importe qui.